Hugging Face ha presentado un método para enviar las actualizaciones de una política de aprendizaje por refuerzo a vLLM sin sincronizar el modelo completo. En un artículo publicado el 10 de septiembre de 2026, la compañía afirma que AsyncGRPOTrainer de TRL v1.14 puede entrenar un adaptador LoRA y sincronizar únicamente ese adaptador con vLLM. El patrón está pensado para infraestructuras distribuidas en las que el entrenamiento y las réplicas de inferencia funcionan como trabajos separados.
La actualización deja de mover el modelo completo
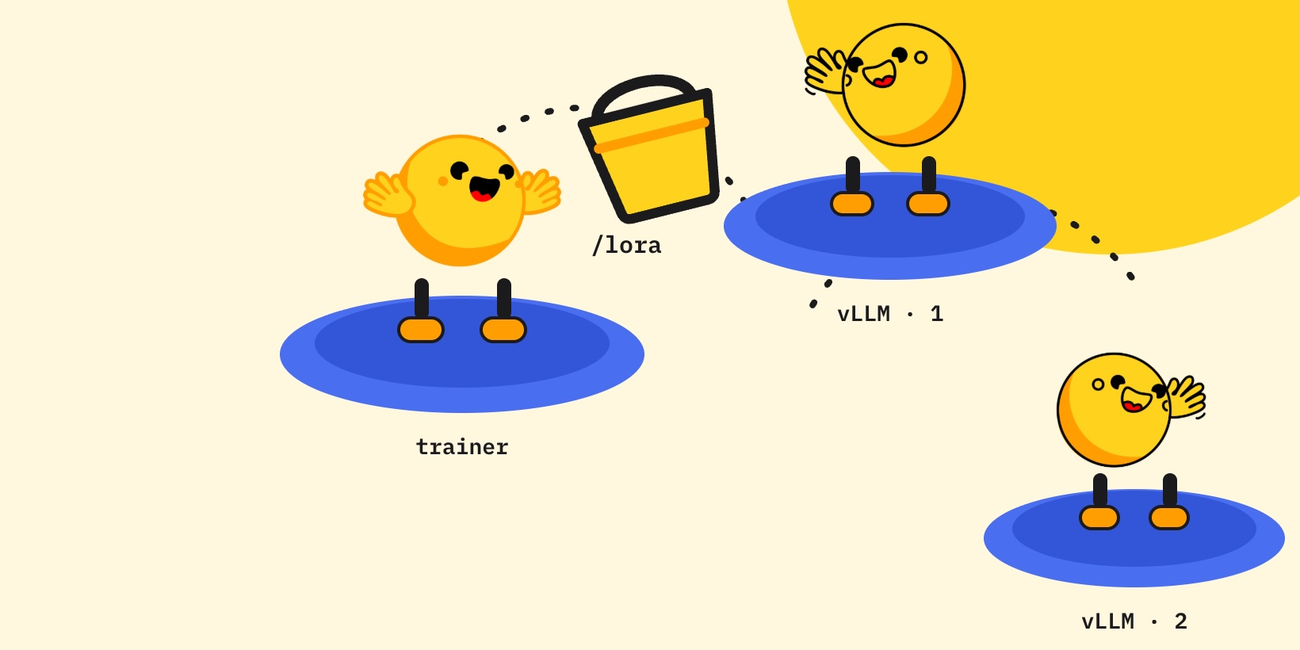
Para un modelo de 1.500 millones de parámetros, Hugging Face sitúa un adaptador LoRA de rango 1 en unos pocos megabytes, frente a unos 3 GB del modelo completo. En este diseño, la actualización de política que circula entre los trabajos es el adaptador. Las réplicas de vLLM conservan el modelo base y reciben las versiones publicadas del adaptador.
La diferencia reduce la cantidad de estado que debe trasladarse en cada sincronización. Eso puede aliviar el coste de comunicación en un flujo de aprendizaje por refuerzo distribuido, aunque no convierte el resultado en una medida universal para cualquier carga de trabajo AsyncGRPO. Las cifras dependen de la receta de entrenamiento y del despliegue utilizados en la demostración.
La arquitectura separa el sistema en un trabajo de entrenamiento y dos trabajos de vLLM, cada uno ejecutado en una máquina independiente. Los tres comparten un bucket de almacenamiento montado en la misma ruta. El entrenamiento puede dejar allí los adaptadores y las dos réplicas de vLLM pueden leer las versiones que se van publicando.
Una publicación versionada evita cargas incompletas
En cada sincronización, el entrenador escribe el adaptador en output_dir/.vllm_lora/trl-policy-v{N}. La publicación se completa mediante un cambio de nombre atómico, de modo que la ruta queda disponible como una versión terminada antes de solicitar su carga. Después, el entrenador envía esa ruta al endpoint de vLLM /v1/load_lora_adapter.
El cambio de nombre evita que una réplica intente cargar un archivo mientras todavía se está escribiendo. La solicitud recibe un adaptador identificado por nombre y versión una vez completada la publicación. El mecanismo encaja con un flujo en el que varias réplicas deben seguir las actualizaciones del entrenamiento sin leer estados parciales.
El proxy mantiene alineadas las réplicas
La coordinación recae en un proxy. Este añade un encabezado Authorization: Bearer con el token de Hugging Face a las solicitudes dirigidas a los puertos expuestos por los trabajos.
Las solicitudes de completado se enrutan hacia la réplica que probablemente tenga el prefijo correspondiente en su caché KV. En cambio, las solicitudes para cargar adaptadores, pausar y reanudar el servicio se difunden a todas las réplicas. La diferencia evita que una actualización parcial del estado entre servidores deje distintas versiones activas dentro del mismo flujo de inferencia.
Cada réplica de vLLM utiliza una GPU y la imagen vllm/vllm-openai 0.27.1 en la demostración. Con max_staleness=4, la configuración reserva seis ranuras para adaptadores de vLLM: una para la política actual, cuatro para versiones anteriores y una ranura adicional durante el reemplazo. Las ranuras, el bucket compartido y el proxy forman parte del diseño necesario para mantener el ciclo de actualización.
Los 53 minutos corresponden a una receta concreta
Hugging Face afirma que cinco ejecuciones de la misma receta durante 500 pasos pasaron de 3 horas y 27 minutos a 53 minutos. La cifra corresponde a la configuración y receta publicadas por Hugging Face, por lo que no debe extrapolarse a cualquier infraestructura o carga de trabajo AsyncGRPO.
El resultado sí muestra qué cambio operativo propone el patrón: coordinar la transferencia de una política versionada como adaptador LoRA mediante almacenamiento compartido y solicitudes de carga en vLLM. El modelo completo deja de ser la unidad que se sincroniza en cada actualización. A cambio, el despliegue sigue necesitando un proxy, almacenamiento compartido, capacidad reservada para adaptadores y control coordinado de las réplicas.
Para los equipos que evalúan entrenamiento distribuido con aprendizaje por refuerzo, el compromiso es claro. El volumen trasladado puede ser mucho menor, pero la arquitectura introduce varios componentes que deben funcionar juntos y una política de conservación de versiones. La capacidad de adaptadores debe cubrir la política actual, las versiones anteriores y el reemplazo previsto por la configuración.
La propuesta presenta, por tanto, un patrón de infraestructura acompañado de una mejora de tiempo comunicada bajo condiciones específicas. Su interés está en cambiar qué se sincroniza entre el entrenamiento y la inferencia; los 53 minutos no constituyen una promesa general de rendimiento.