Hugging Face présente une méthode destinée à transférer les mises à jour de politique issues de l'apprentissage par renforcement vers vLLM sans synchroniser le modèle complet. Dans un article publié le 10 septembre 2026, l'entreprise indique que l'AsyncGRPOTrainer de TRL v1.14 peut entraîner un adaptateur LoRA, puis synchroniser uniquement cet adaptateur avec vLLM. Le changement concerne surtout les architectures distribuées dans lesquelles l'entraînement et les répliques d'inférence fonctionnent comme des tâches distinctes.
Un adaptateur de quelques mégaoctets au lieu du modèle complet
Hugging Face prend l'exemple d'un modèle de 1,5 milliard de paramètres. Dans cette configuration, un adaptateur LoRA de rang 1 représente quelques mégaoctets, contre environ 3 Go pour le modèle complet. La mise à jour de politique échangée entre les tâches porte donc sur l'adaptateur, tandis que les répliques vLLM continuent de servir le modèle de base avec les adaptateurs publiés.
Cette différence réduit la quantité d'état du modèle impliquée dans chaque synchronisation. Elle ne suffit toutefois pas à rendre l'architecture indépendante de son déploiement : le gain rapporté dépend de la recette utilisée et de la manière dont les tâches d'entraînement et d'inférence sont réparties.
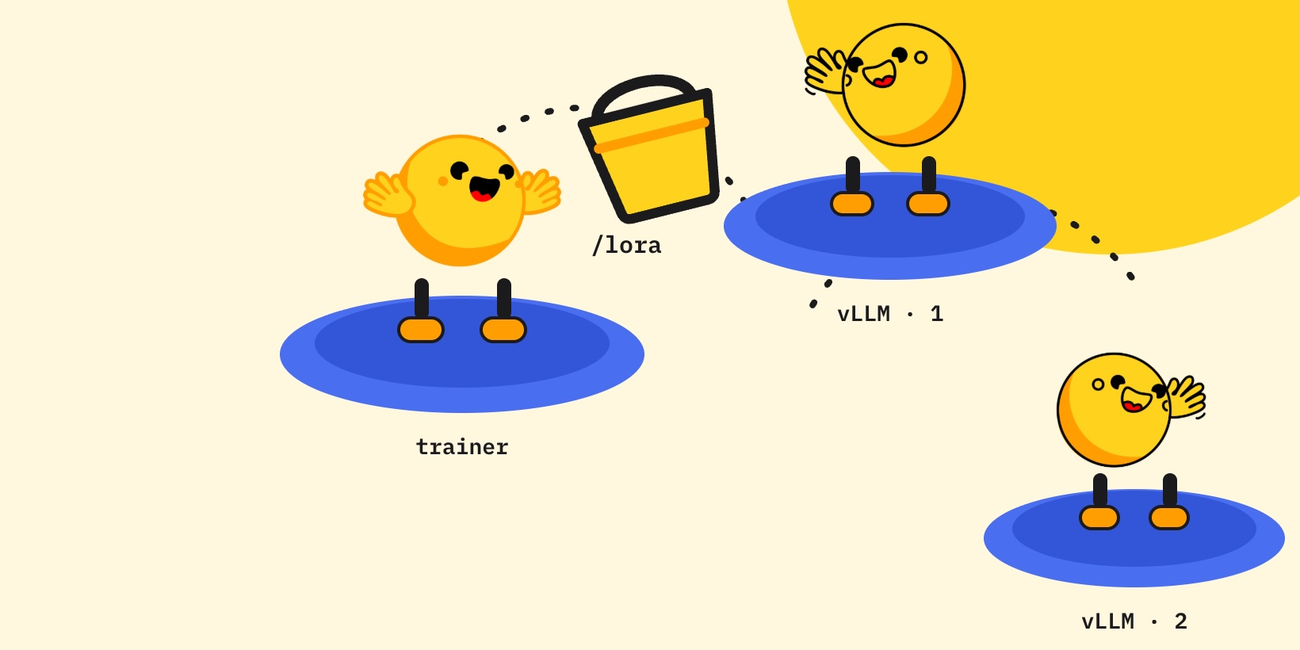
La démonstration sépare le système en une tâche d'entraînement et deux tâches vLLM, chacune exécutée sur une machine distincte. Les trois tâches montent le même bucket de stockage au même chemin. L'entraînement peut ainsi publier les adaptateurs dans cet espace partagé, puis les deux répliques vLLM lire les versions disponibles sans recevoir une nouvelle copie complète du modèle.
Une publication versionnée pilotée par le proxy
À chaque synchronisation, le formateur écrit l'adaptateur dans output_dir/.vllm_lora/trl-policy-v{N}. Il le publie ensuite au moyen d'un renommage atomique, avant d'envoyer son chemin au point de terminaison vLLM /v1/load_lora_adapter. La requête de chargement reçoit ainsi un adaptateur identifié et versionné une fois sa publication terminée.
Le proxy coordonne les échanges entre les tâches. Il ajoute aux requêtes destinées aux ports exposés l'en-tête Authorization: Bearer contenant le jeton Hugging Face. Les requêtes de complétion sont dirigées vers la réplique qui a probablement le préfixe de cache KV concerné. À l'inverse, les requêtes de chargement d'adaptateur, de mise en pause et de reprise sont diffusées à toutes les répliques.
Ce routage ne constitue donc pas un simple détail de connexion. Il organise à la fois la distribution des complétions et la propagation des changements de politique vers l'ensemble des instances vLLM. Pour les équipes qui reprennent cette architecture, le stockage partagé, le proxy et les requêtes de contrôle font partie du mécanisme de synchronisation.
Six emplacements d'adaptateurs dans la configuration présentée
Chaque réplique vLLM utilise un GPU et l'image vllm/vllm-openai en version 0.27.1 dans la démonstration. La configuration utilise également max_staleness=4. Elle réserve alors six emplacements pour les adaptateurs vLLM : un pour la politique actuelle, quatre pour les versions précédentes et un emplacement supplémentaire pendant le remplacement.
La capacité réservée aux adaptateurs devient ainsi une contrainte concrète du déploiement. La synchronisation LoRA allège le transfert de la mise à jour, mais elle exige de prévoir la conservation de plusieurs versions, le remplacement de l'adaptateur actif et la coordination entre les répliques.
Un temps de calcul divisé dans l'exemple de Hugging Face
Hugging Face indique que cinq exécutions de la même recette, sur 500 étapes, sont passées de 3 heures 27 minutes à 53 minutes. Ces chiffres correspondent à la configuration publiée par l'entreprise et ne constituent pas un benchmark reproduit indépendamment. Ils illustrent le gain potentiel obtenu en combinant des adaptateurs de petite taille avec la séparation entre entraînement et service, sans garantir la même durée pour toutes les charges de travail AsyncGRPO.
Le changement intéresse donc les équipes qui évaluent une infrastructure d'apprentissage par renforcement distribué et cherchent à limiter les transferts entre tâches. Le compromis reste opérationnel : il faut un proxy, un bucket partagé, des emplacements suffisants pour les adaptateurs et des requêtes de contrôle synchronisées.
TRL v1.14 propose ici une architecture de synchronisation centrée sur LoRA pour AsyncGRPO, avec un résultat de 53 minutes sur la recette mesurée par Hugging Face. Ce chiffre renseigne sur le potentiel de la configuration présentée, pas sur une durée universelle. La décision dépendra donc autant du gain de transfert que de la capacité à maintenir cette organisation distribuée.